
能搜索资料、运行代码,还能完成多步科学研究任务——训练这样的智能体,究竟需要多少道工序?
中期训练、监督微调、偏好优化、在线策略蒸馏、强化学习…… 随着智能体能力不断增强,训练流程也变得越来越长。每增加一个环节,研究者就需要准备相应的数据,协调新的训练目标,再调试一套训练参数。
来自杜克大学、字节跳动、马里兰大学帕克分校和纽约州立大学布法罗分校的研究团队,推出了 Axion 1.0。其训练流程只包含两阶段监督微调(SFT)和强化学习(RL),没有额外安排中期训练(mid-training)、直接偏好优化(DPO)或在线策略蒸馏(OPD)。
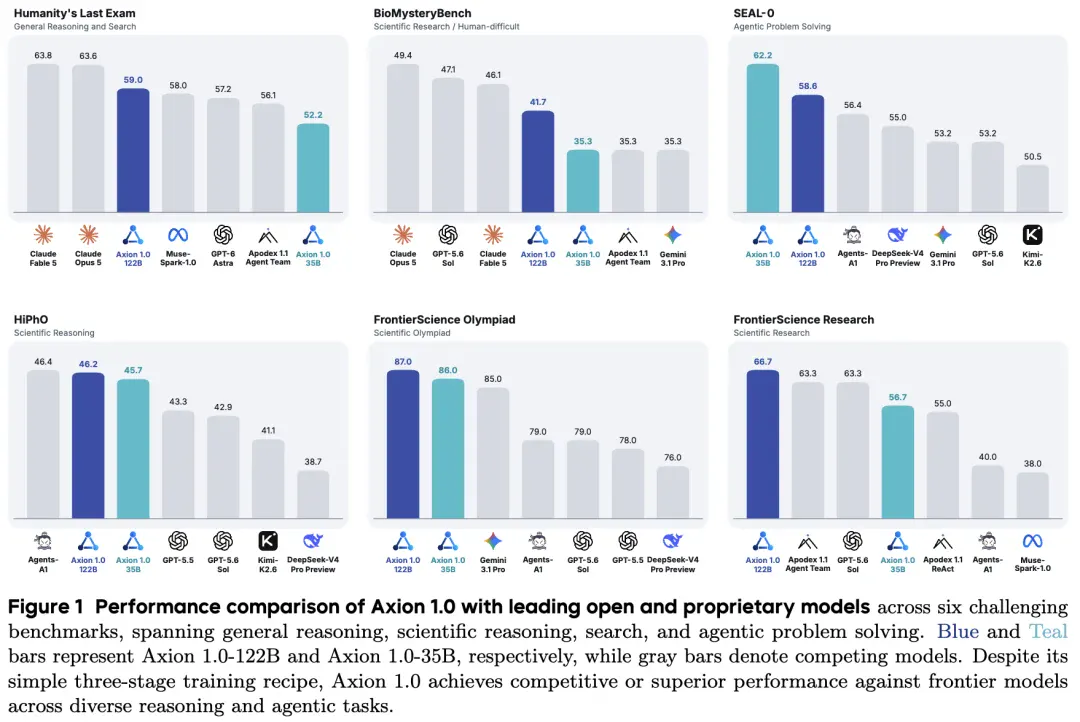
凭借这套简洁的训练流程,Axion 1.0 展现出强势的科学推理和工具使用能力。论文报告,Axion 1.0-122B 在限制部分网站访问的完整 Humanity』s Last Exam(HLE)评测中取得 59.0%(超越 GPT-6),在 FrontierScience Research 上取得 66.7%;35B 版本在信息搜寻基准 SEAL-0 上取得 62.2%。
更重要的是,团队全面开源了数据构造、生成、筛选、验证、提示词及训练代码,向社区公开了完整训练方法。简洁的三阶段流程与透明的开源实现,让智能体基础模型的训练不再神秘,也让更多人能够训练自己的强大的智能体模型。
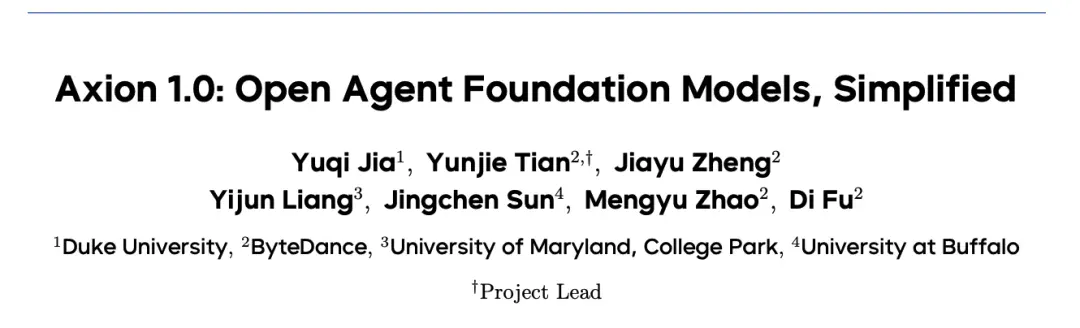
- 论文:https://arxiv.org/abs/2611.03233
- 项目:https://axion1-0.github.io
- 代码:https://github.com/bytedance/axion1_0
- 数据:https://huggingface.co/datasets/Axion1-0/axion-training-data
- 模型:https://huggingface.co/Axion1-0/Axion-1.0-35B
方法介绍
Axion 1.0 成功的关键,在于针对智能体所需的不同能力,构造高质量的训练数据。具体而言,Axion 1.0 将智能体的训练任务分为两类:一类根据题目提供的完整信息进行推理与计算,另一类需要借助工具获取缺失的外部信息,再结合证据完成推理。两个 SFT 阶段分别围绕这两类任务展开,让模型先提升推理能力,再学习如何获取和利用外部信息。
第一步 给已经会做的题增加挑战
第一阶段使用数学、物理、化学、生物和计算机科学等领域的题目,训练模型的多步推理与计算能力。然而,很多公开题目,基础模型已经能答对。继续用这些题目训练,怎样提供更多学习空间?Axion 1.0 的办法是,根据基础模型的作答表现,有针对性地提高题目难度。
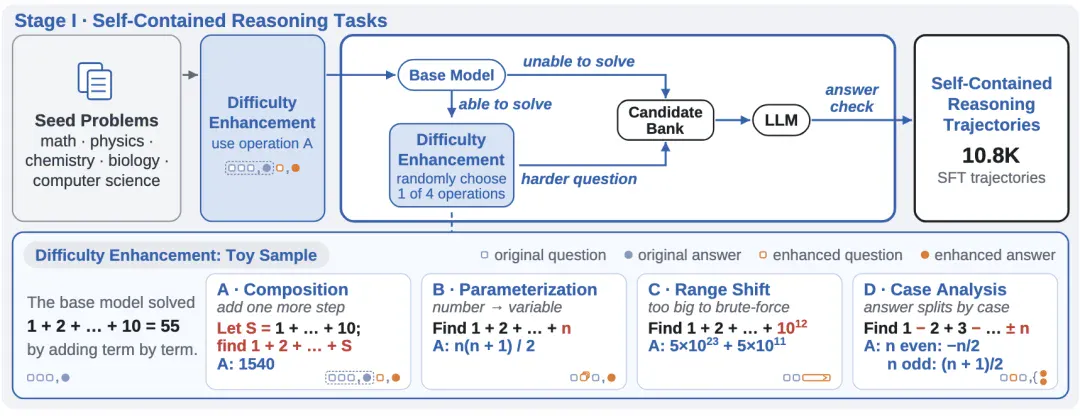
研究团队首先对种子题进行难度增强:把原题的答案变成新问题中的中间量,让解题增加一层依赖。随后让基础模型尝试:答错的题目进入候选池;答对的题目,则连同成功解法一起交给生成模型,进一步增加难度。
例如,种子题目要求算出从 1 到 10 的和,新题目就可以把固定数值替换成参数,要求给出一般表达式;也可以扩大取值范围,让原来的枚举策略难以奏效。其他改写方式还包括增加依赖前一步结果的推理,以及引入需要分类讨论的条件,甚至是这些策略的组合。
每次改写后,参考答案都会重新验证,条件不足或答案不明确的题目被剔除。随后收集正确的解题轨迹,形成约 1.08 万条第一阶段 SFT 数据。这个阶段允许使用 Python,但不开放搜索和网页访问,让模型先学会处理题目内部的推理与计算。
第二步 让模型必须走出去寻找答案
除了较强的内部推理能力,智能体模型在遇到使用内部知识无法解答的题目时,还需要判断缺少什么信息、到哪里查找,以及如何把查到的内容用于推理。第二阶段的任务构造,正是围绕这些能力展开。
Axion 1.0 从公开结构化数据出发,由程序完成筛选、选定唯一实体和计算答案,再让语言模型把这个过程写成自然语言问题。参考答案在出题时就已经确定,便于之后验证模型是否真正做对了题目。
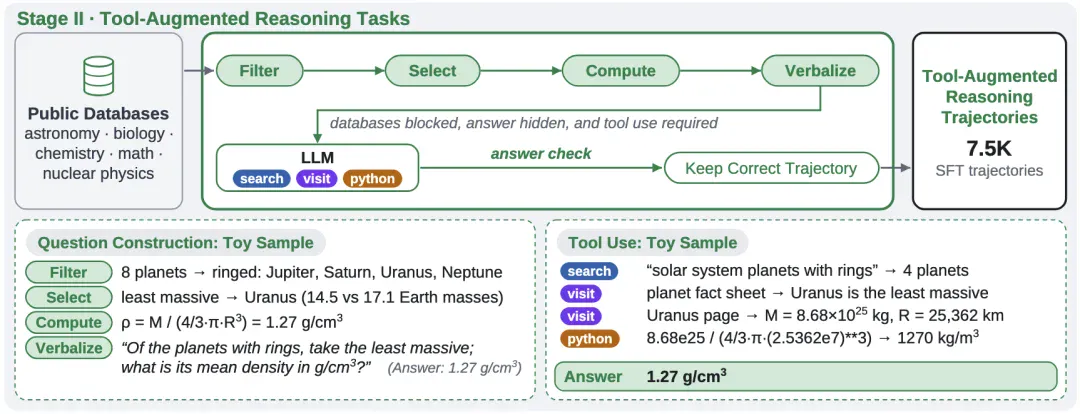
论文给出了一个直观示例:在有行星环的太阳系行星中,找出质量最小的一颗,再计算其平均密度。模型需要先确定天王星,查到质量和半径,最后完成计算。一个问题由此串起实体识别、事实检索和数值计算。
收集轨迹时,出题使用的数据库表和参考答案不会直接提供给模型;模型需要通过搜索、网页访问和 Python 得到所需信息。无需检索就能答对的问题也会被过滤。程序还会检查实体选择是否唯一、参数是否齐全,以及自然语言改写是否遗漏条件或泄露答案。最终,第二阶段保留约 7500 条正确工具交互轨迹。两阶段 SFT 都保留完整交互上下文,只对助手生成的推理、工具调用和回答计算训练损失。
第三步 在真实工具交互中继续学习
有了推理和工具使用的示范,35B 与 122B 主模型进一步使用异步 GRPO 进行强化学习,在搜索、网页访问、学术检索和 Python 环境中生成自己的解题轨迹。
RL 阶段最关键的设计是阶段性的奖励机制 (reward)。而这个实现又依赖于之前的数据构造的设计。程序化出题既能提供最终答案,也能记录解题过程中应得到的实体和数值。因此,模型最终答对时获得完整奖励;没有答对时,经过验证的中间进展仍可获得部分奖励,同时对未提交最终答案的情况施加惩罚。
中间进展也有先后依赖。例如,先选对实体,再获取参数,最后计算,后续步骤只有在前置步骤通过检查时才能计入进展。需要外部依据的实体识别,还必须得到工具观察的支持。这样,检索结果中偶然出现正确内容,不会直接被当作模型已经完成了推理。
实验结果
Axion 1.0 的两个主模型分别基于 Qwen3.6-35B-A3B 和 Qwen3.5-122B-A10B。团队在六项评测中观察其科学推理、信息搜寻和工具使用能力。
主要结果
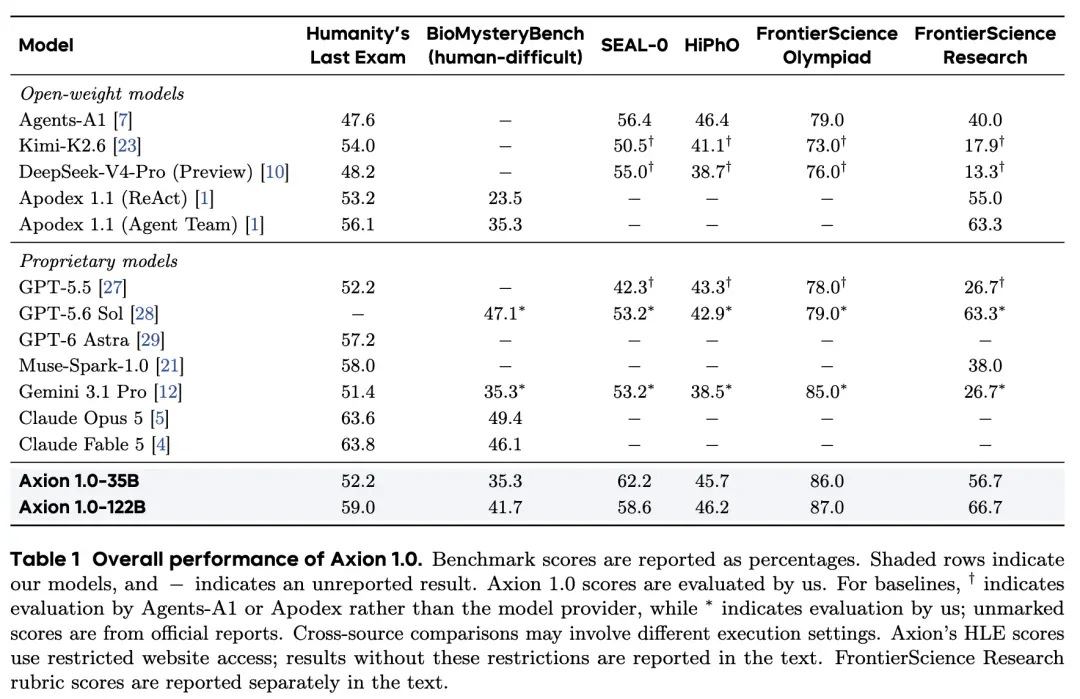
- HLE:Axion 122B 取得 59.0%,高于论文列出的 GPT-6 Astra(57.2%)和 GPT-5.5(52.2%),接近 Claude Opus 5(63.6%)与 Claude Fable 5(63.8%)。
- FrontierScience Research:Axion 122B 取得 66.7%,超过 GPT-5.6 Sol(63.3%),也高于 GPT-5.5(26.7%)。
- FrontierScience Olympiad:122B 和 35B 版本分别取得 87.0% 和 86.0%,均超过 GPT-5.6 Sol(79.0%)和 Gemini 3.1 Pro(85.0%)。
- SEAL-0:35B 版本取得 62.2%,超过 GPT-5.6 Sol(53.2%)、Gemini 3.1 Pro(53.2%)和 Agents-A1(56.4%)。
- HiPhO:122B 版本取得 46.2%,高于 GPT-5.6 Sol(42.9%)和 GPT-5.5(43.3%)。
各训练阶段的效果
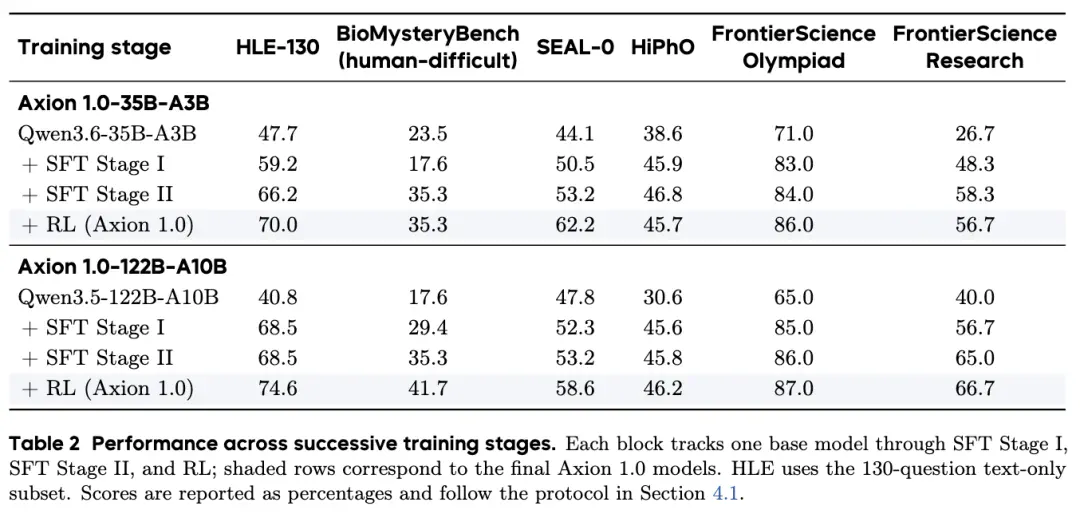
以 35B 模型为例,第一阶段 SFT 后,FrontierScience Olympiad 从 71.0% 提升至 83.0%,体现出科学推理能力的增强;第二阶段引入工具使用训练后,BioMysteryBench 从 17.6% 提升至 35.3%,FrontierScience Research 从 48.3% 提升至 58.3%;RL 则进一步将 SEAL-0 从 53.2% 提升至 62.2%。连续训练检查点的结果展示了模型从推理、信息获取到多步工具交互的能力提升过程。
不同基础模型
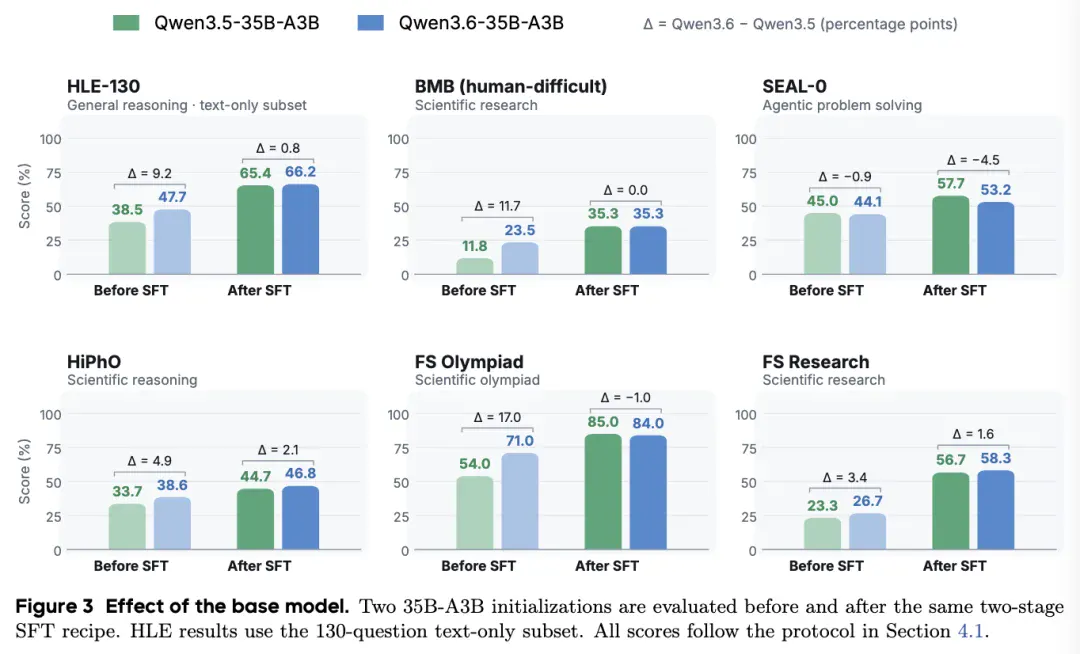
在 Qwen3.5-35B-A3B 和 Qwen3.6-35B-A3B 上应用了相同的两阶段 SFT 方法。训练前,两者在 HLE-130 上相差 9.2 个百分点;训练后,差距缩小至 0.8 个百分点,在 BioMysteryBench 上则均达到 35.3%。这些结果表明,Axion 1.0 的训练方法能够适用于不同底座,帮助起点较弱的模型显著缩小性能差距。
模型规模
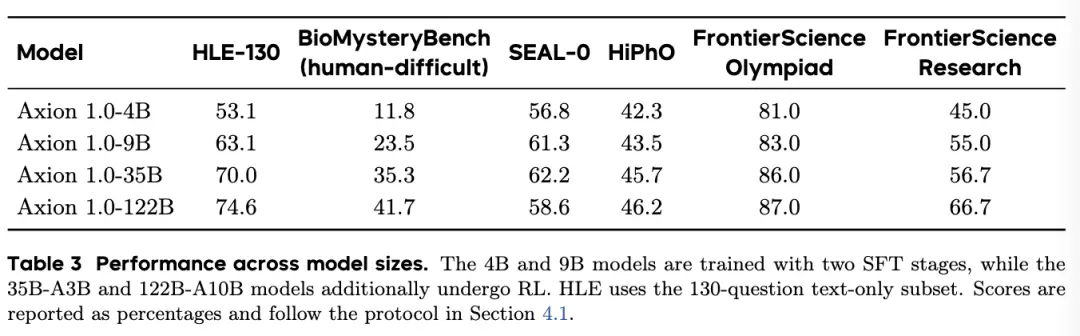
Axion 1.0 的训练方法也被应用于 4B 和 9B 模型。仅经过两阶段 SFT,两个小模型在 HLE-130 上分别取得 53.1% 和 63.1%,在 FrontierScience Olympiad 上分别达到 81.0% 和 83.0%;9B 模型在 FrontierScience Research 上也取得了 55.0%。说明所构造的训练数据在较小模型上同样有效。
回到最初的问题:训练一个强大的智能体,究竟有多简单?Axion 1.0 展示了一条只包含两阶段 SFT 和 RL 的可行路径。支撑它的是经过设计和验证的学习任务:用模型已有的解法指导难度提升,用公开数据构造需要外部证据的问题,再通过工具交互中的奖励继续优化。
团队已公开数据构造及训练和测试代码。对于希望复现和改进智能体训练的研究者,这些材料提供了一个具体起点。
相关文章
 津公网安备12011002023007号