




LibTV 是由 LiblibAI 于2026年3月18日推出的全球首款同时面向人类创作者与AI Agent的AI视频创作平台。它并非单一的视频生成工具,而是一个集成了剧本、分镜、视频生成、剪辑等环节的一站式创作系统,旨在解决传统AI视频创作中工具割裂、流程繁琐的核心痛点。
🎨 核心定位:双入口创作范式
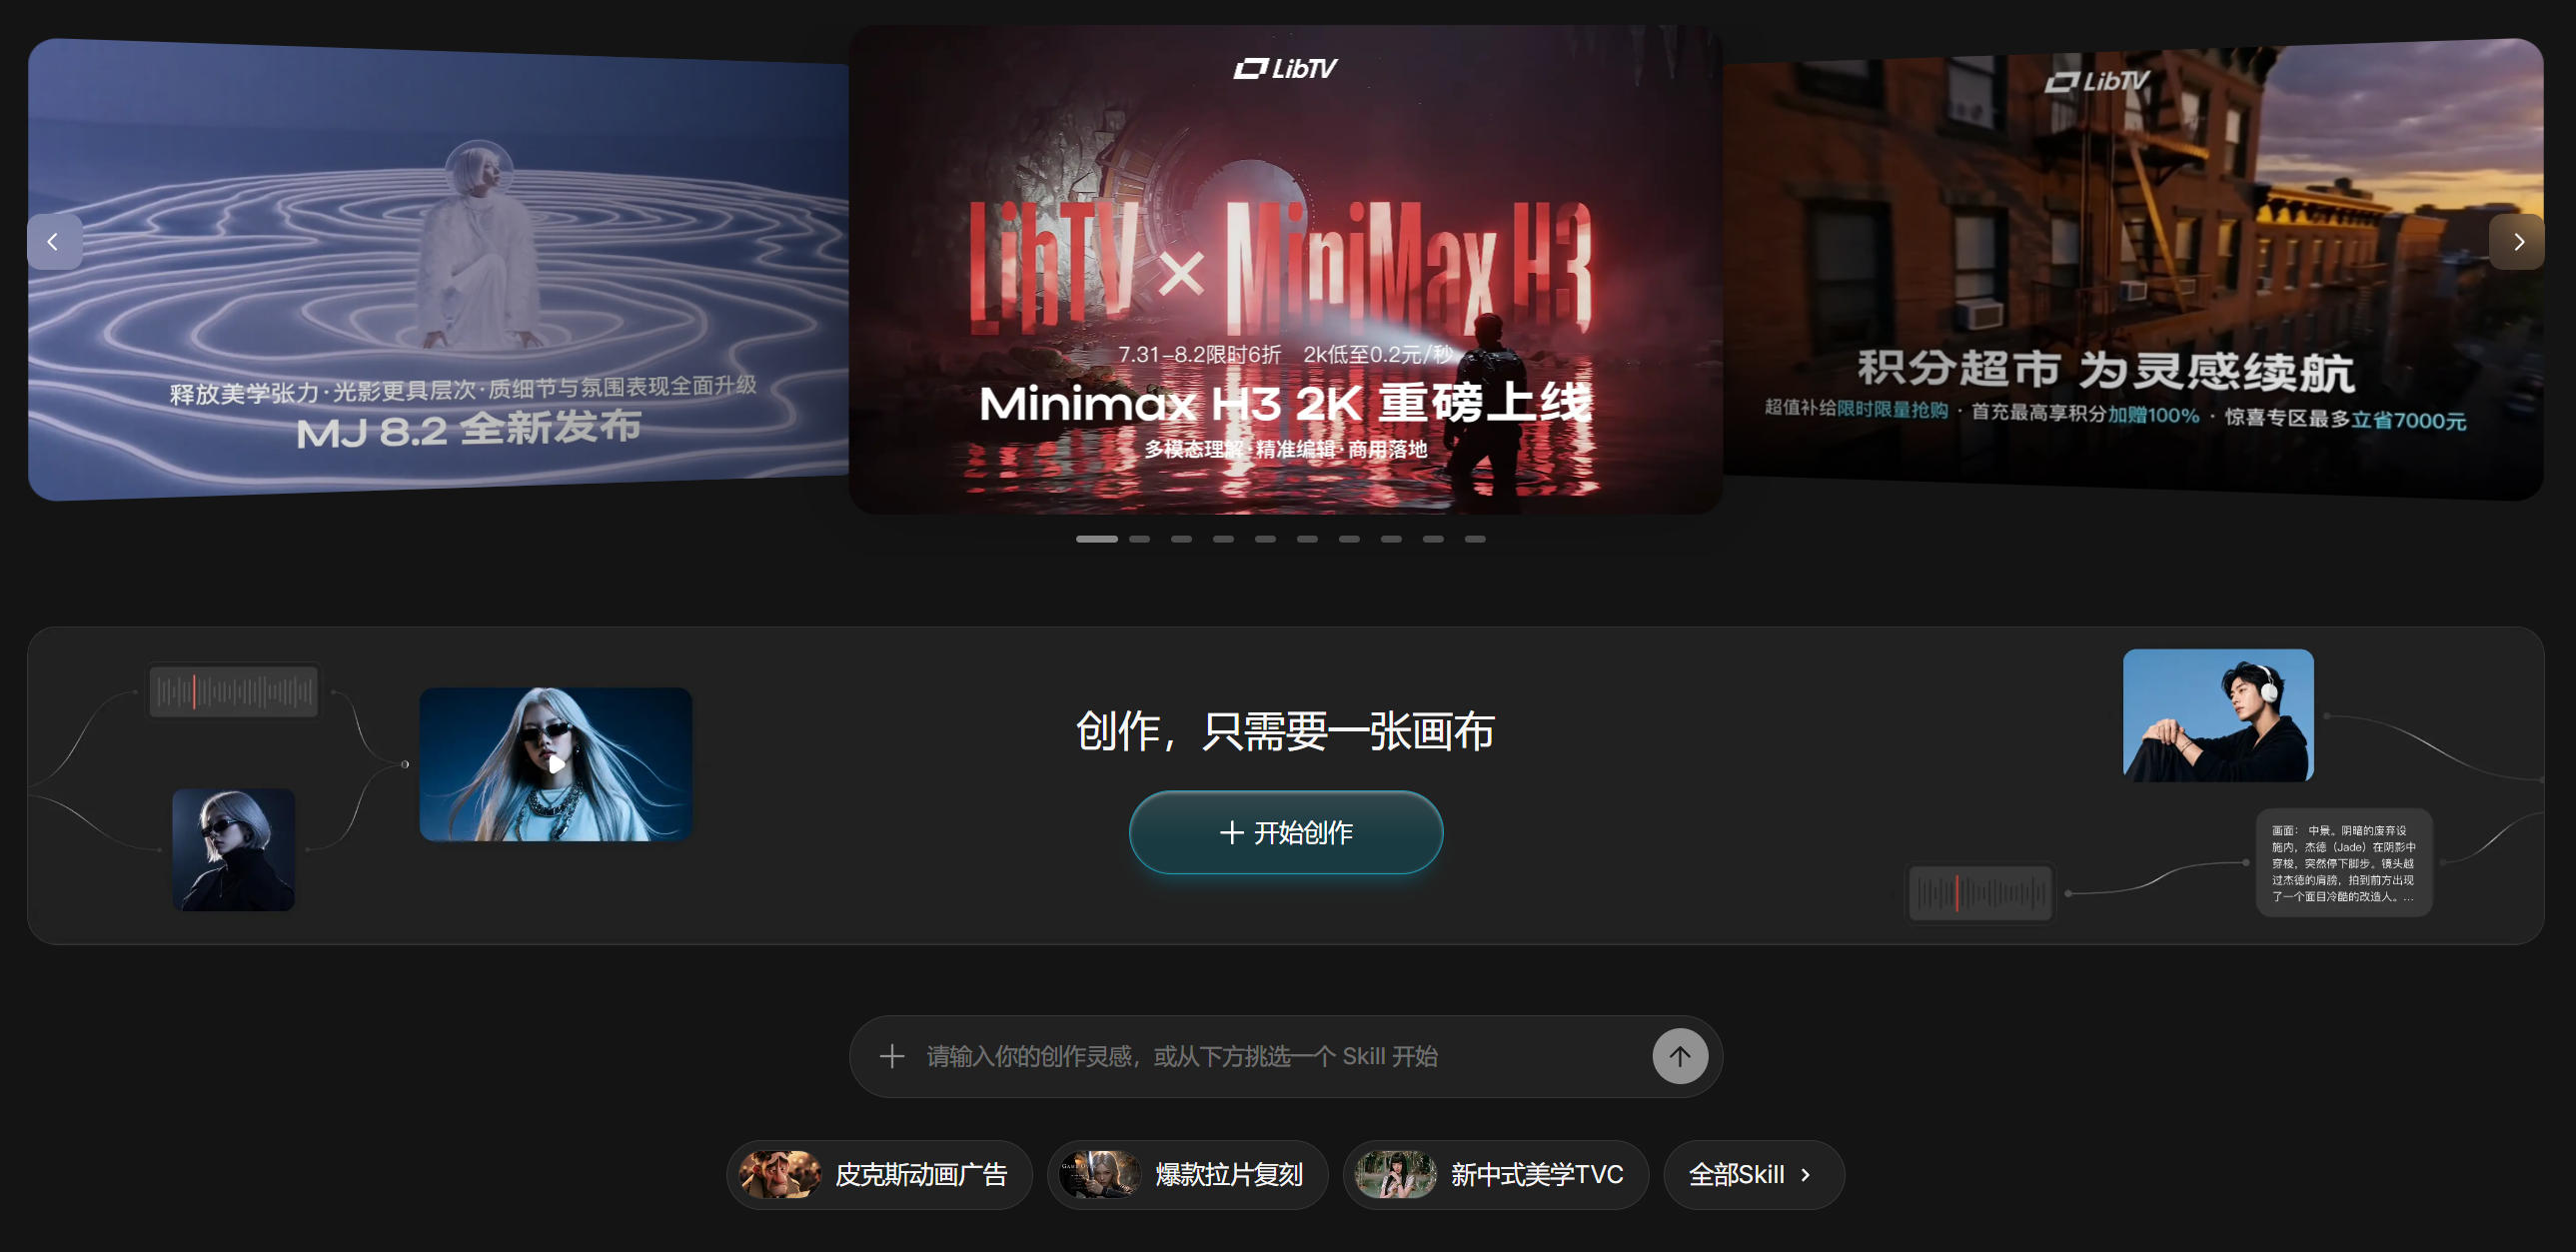
LibTV 的核心创新在于其“双入口”设计,兼顾了人类的专业创作与AI Agent的自动化生产。
- 人类创作者工作台:提供“无限画布 + 节点式工作流”的图形界面。创作者可以在一个可视化空间中自由编排剧本、分镜、视频、音频等节点,实时调整镜头、光影、运镜等专业参数,实现从创意到成片的全链路、结构化创作,而非传统的线性或对话式交互。
- AI Agent 智能入口:开放标准化的 Skill 接口(已在GitHub开源),支持 OpenClaw 等主流 AI Agent 直接调用。用户只需通过自然语言指令(如“生成一个30秒的国风水墨动画”),Agent 即可自主完成从剧本创作、分镜设计到视频渲染、剪辑合成的全流程。
🛠️ 核心功能与创作引擎
LibTV 集成了超过20项独家功能,覆盖视频创作的专业环节。
智能化创作引擎
- 分镜批量生成:输入剧本后,可在2分钟内自动生成包含景别、机位、运镜提示的9/25宫格专业分镜脚本,效率较传统流程大幅提升。
- 动态叙事推演:基于关键帧自动补全前后剧情,支持多镜头视角同步生成,辅助创作者拓展叙事。
- 音画同步技术:集成 OmniHuman 1.5 等模型,可实现音频驱动画面生成,例如根据歌曲节奏自动适配场景切换。
工业化生产工具
- 节点式修改系统:支持对任意分镜或视频片段进行单点重新生成,修改后自动同步更新后续节点,避免全局返工。
- 专业控制功能:提供角色三视图生成、主体库(角色一致性管理)、电影级灯光控制(24种主光位、9种轮廓光预设)、镜头聚焦、720°全景视频等精细化控制能力。
- 多平台交付兼容:原生支持导出剪映工程文件,保留分层时间轴数据,便于进行专业精调。
- 实用辅助功能:包括一键智能消除字幕、一键整理杂乱画布、分镜组智能排序等,提升创作体验。
🤝 团队协作与生态
为满足专业团队的规模化生产需求,LibTV 于2026年5月18日正式上线团队版。
- 多人实时协作:支持导演、编剧、美术、后期等角色在共享画布上并行编辑,实时同步状态,消除版本混乱,大幅缩短制作周期。
- 统一团队资产库:提供共享的角色、风格、素材库,确保跨集、跨镜头的角色一致性与内容风格统一,方便团队成员复用。
- 精细化成本管理:支持根据团队规模和项目需求灵活采购资源,并提供成员产出与资产归属的追踪统计,解决团队算力成本不透明的问题。
⚙️ 技术底座与模型集成
LibTV 本身不直接研发底层模型,而是通过整合行业顶尖模型与算力资源,构建创作基础设施。
- 多模态模型体系:集成了可灵3.0、Seedance 2.0、Wan 2.6、Midjourney V7、Mureka 音频模型等主流模型,覆盖文本、图像、视频、音频全链路。
- 成本与性能优势:凭借广泛的模型与云算力合作网络,LibTV 能够在成本、性能与可用性之间取得灵活平衡。其会员积分成本比竞品低约92%,并为新用户提供300条免费视频生成额度。
📊 市场定位与客观评价
LibTV 在市场中主要定位于追求真人质感与全链路效率的专业团队,尤其在AI短剧、信息流广告等领域获得认可。
- 核心优势:全链路整合能力强,无需在多个工具间切换;在都市、悬疑、情感等现代题材的真人风格生成上,人物肤质、光影和表情的自然度较高;团队版有效解决了协作、资产管理和成本控制等商业化痛点。
- 客观局限:在一些复杂场景下,如古装大场面、多人打斗、快速运镜等,其角色一致性和画面稳定性仍有提升空间。与部分主打3D空间一致性、已服务头部影视公司的工业级平台相比,LibTV 在行业资质背书和顶级商业案例方面相对有限。
LibTV 是一个面向专业视频创作的AI基础设施平台。它通过“双入口”设计和一站式工作流,为人类创作者和AI Agent提供了高效、可控的视频生产环境,特别适合需要稳定、批量产出高质量AI视频内容的团队。




 津公网安备12011002023007号