
Scaling up 是大模型的标志,也引领了近几年语言模型技术的飞跃。然而实际上,大语言模型架构,作为其最本质的计算基础,也在近年来持续发展。GQA、MLA、各式稀疏注意力模块的提出,或是 Mamba、Gated DeltaNet 之类的线性注意力网络,DeepSeek 的细粒度 MoE,还有多 token 预测和 Looped 架构等等,几乎每一版旗舰模型,都在先前架构的基础上提出了新的架构改进。持续学习、测试时训练等新需求也在推动架构继续演变,像 Ilya 创立的 SSI 正在研发能在推理时更新权重的模型。当前的语言模型架构不是终点,这几乎已是领域共识。
最近,「LSTM 之父」Jürgen Schmidhuber 领衔,来自香港大学、KAUST、华为、香港中文大学、北京大学等机构的研究者合作发布了面向大语言模型架构研究领域的深度技术综述。正文共 84 页,引用文献近 600 篇,时间跨越 1913 到 2026,追问下一代语言模型架构的发展方向。
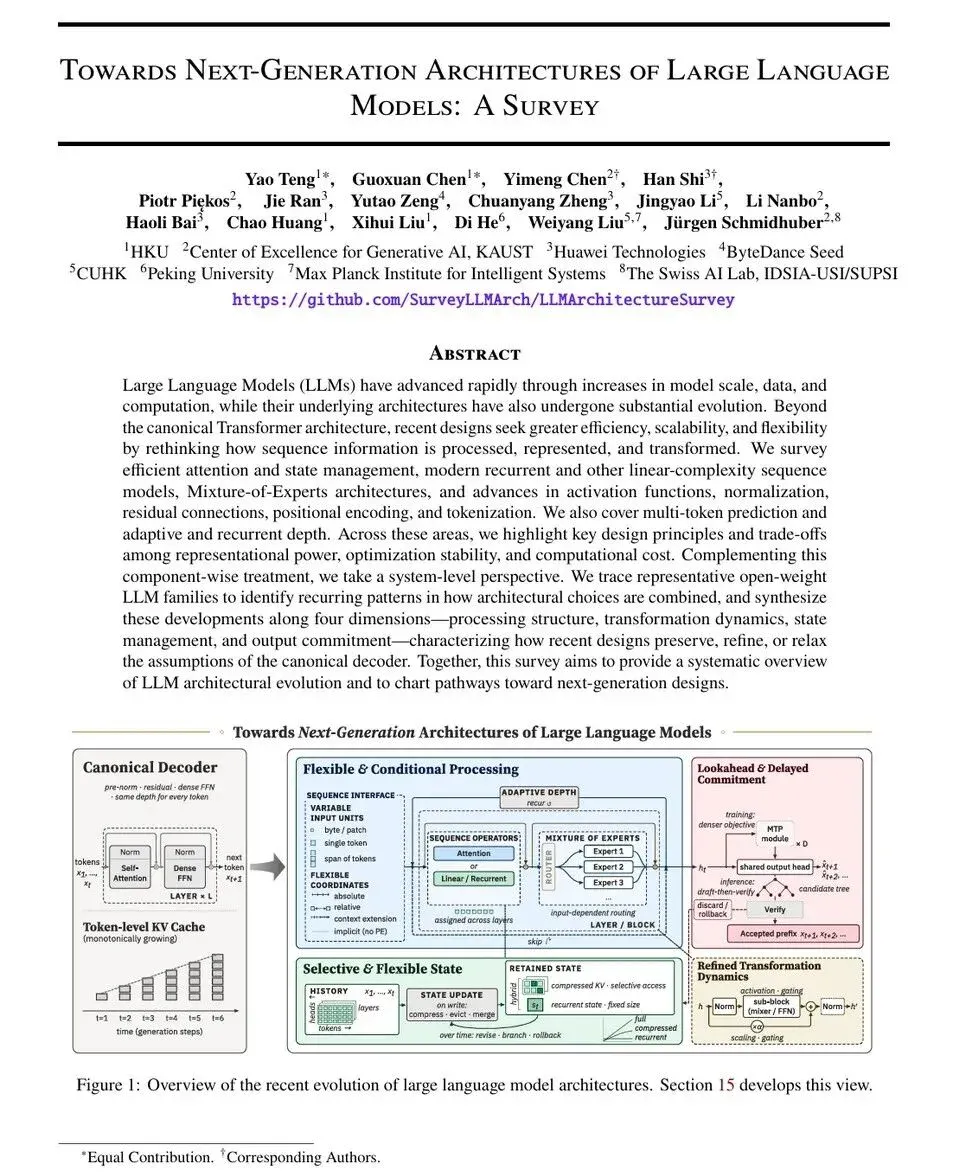
- 论文标题:Towards Next-Generation Architectures of Large Language Models: A Survey
- 论文链接:https://www.preprints.org/manuscript/202610.1532
- 项目主页:https://surveyllmarch.github.io/
- GitHub:https://github.com/SurveyLLMArch/LLMArchitectureSurvey
从 1913 年讲起
语言模型的演变经过了近百年的历史。1913 年,马尔可夫统计了普希金《叶甫盖尼・奥涅金》里元音和辅音的排列,第一次用数据说明语言里存在条件依赖。1948 年,香农把语言看作随机信源。后来,语音识别里的 n-gram 模型、循环网络(1990 年)、LSTM 模型(1991 年)被依次提出。到如今,Transformer 架构支撑起了当前整个大模型领域。
更长的时间跨度让我们可以看到架构技术的交叉演变。比如 1991 年 Schmidhuber 提出的 Fast Weight Programmers 里,有一种加性外积更新规则,其今天可以被称为 “无归一化线性 Transformer”。而 2020 年的核化线性注意力,数学上就等价于给它加上了归一化。此外,LSTM 的乘法门控被 GLU 搬进前馈网络,形成了今天常用的 SwiGLU 网络,而 LSTM 中那条保持误差流的加性通路,也和后来的 Residual Connections 有本质的联系。
模型架构详解
文章先按基础 Transformer 的不同组件,分别总结在其上的相关架构研究工作。囊括了以下方面:高效注意力机制与 KV 缓存管理、线性语言模型、混合专家(MoE)、激活函数、归一化与残差连接、位置编码和分词器。此外,文章还讨论了生成时的计算分配,讨论了多 token 预测、自适应与循环深度等主题。
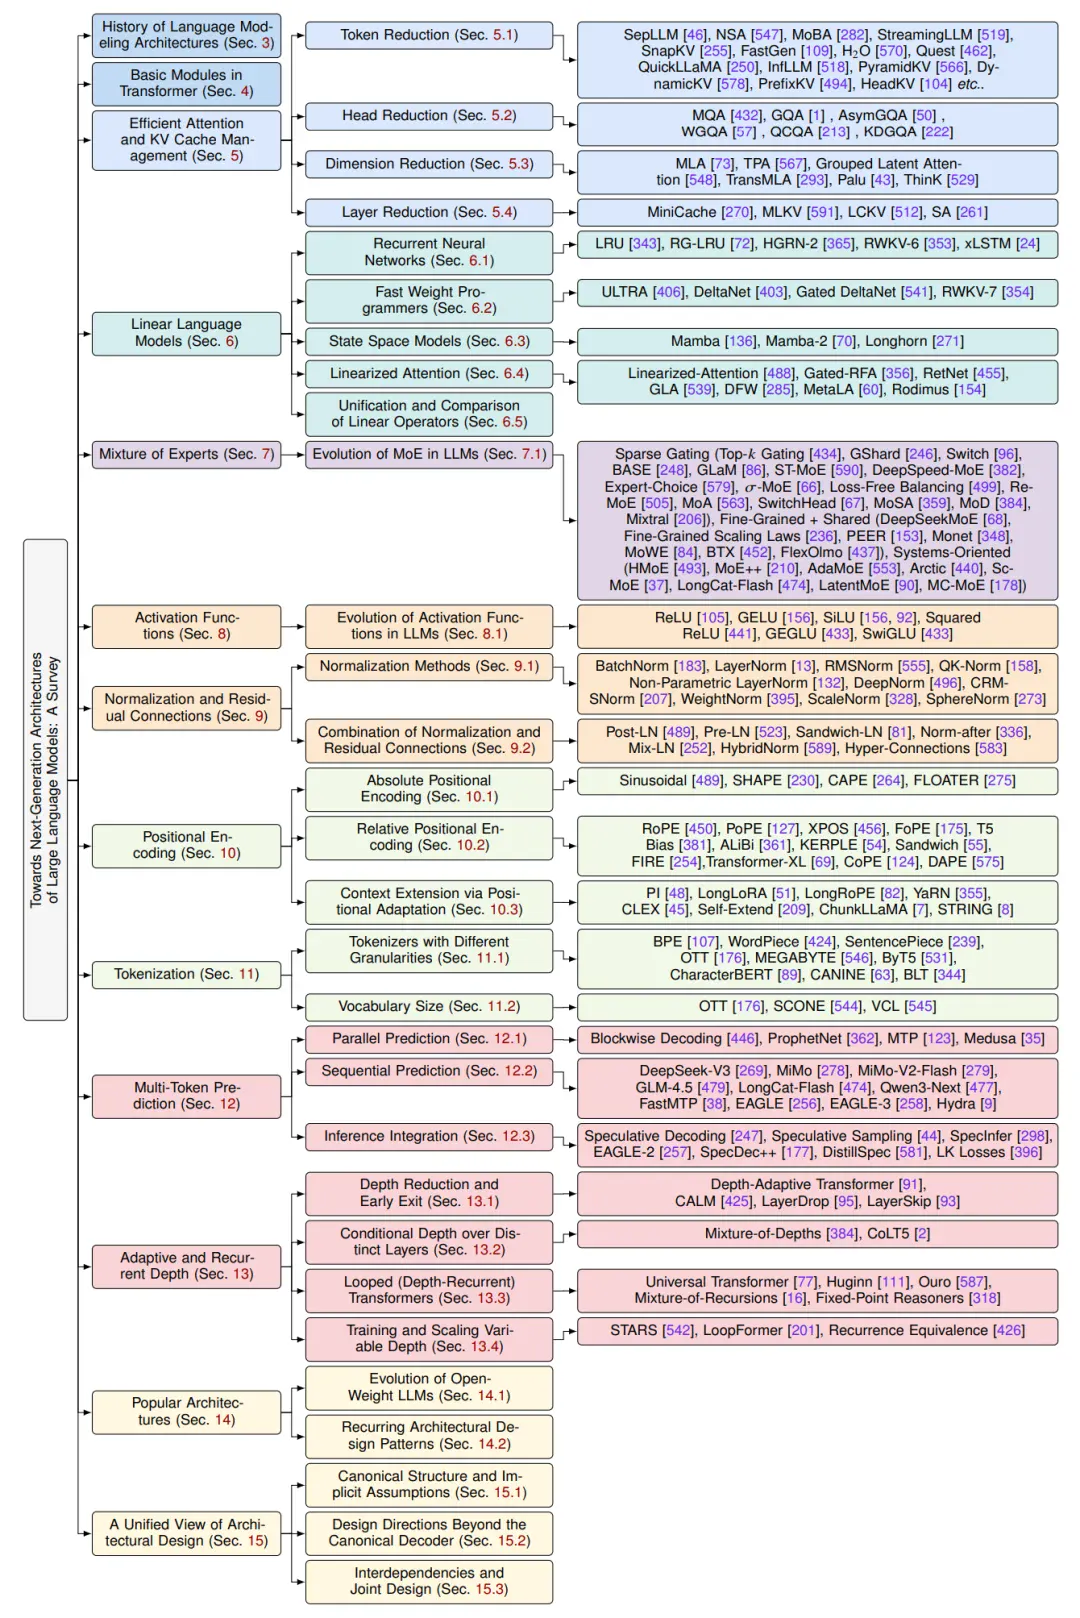
综述分类树,括号内为章节编号
基础模块一章介绍了经典 Transformer 架构的各个组件。当前大语言模型,本质是同一代架构,因为其核心结构都是基于单解码 Transformer 网络(即 decoder-only Transformer)。Decoder-only Transformer 包括标准的 Pre-RMSNorm、SwiGLU 和 RoPE 等模块。每个 token 在前馈过程中需要经过全部的层,KV 缓存随生成线性增长,每次前向预测确定一个 token。
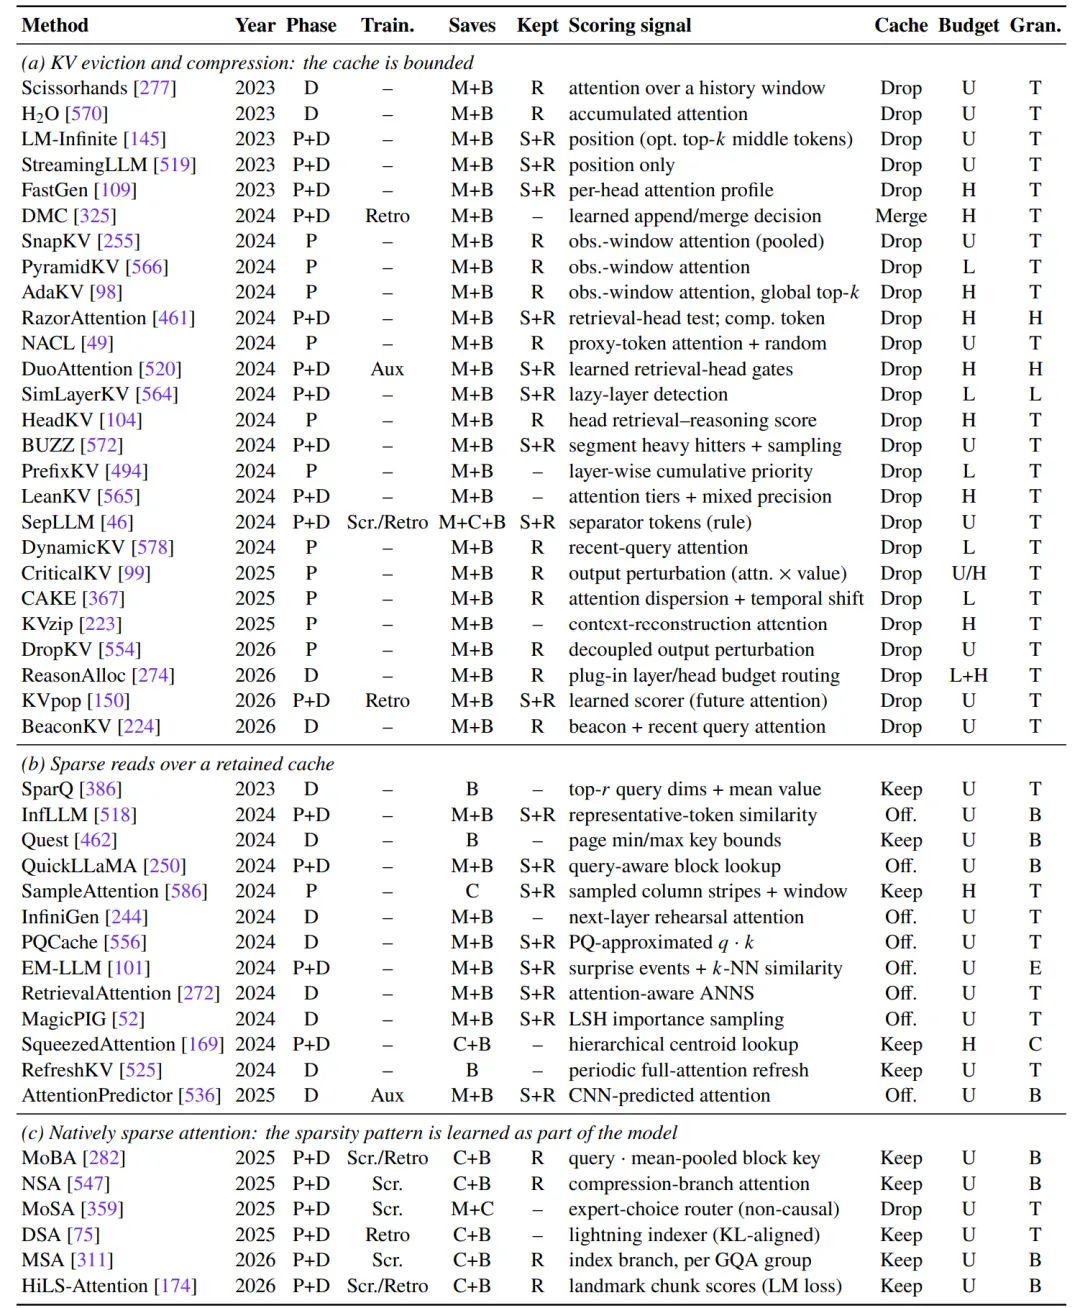
KV 压缩方法(节选自综述表 2),按作用机制分组、按首次公开年份排序。
高效注意力与 KV 缓存一章,把 KV 缓存拆成 “token”、“注意力头”、“头维度”、“层” 这四个维度来归类。稀疏注意力大多落在 token 维度,比如 StreamingLLM、H2O、SepLLM,以及 NSA、MoBA 这类可训练的块稀疏方法。而 MQA、GQA 在头上做共享,MLA 在特征维度做低秩压缩,MiniCache 等方法则跨层共享。作者也提醒,这些方法主要省的是显存和访存,真正能把平方计算量降下来的方法只占其中一部分。
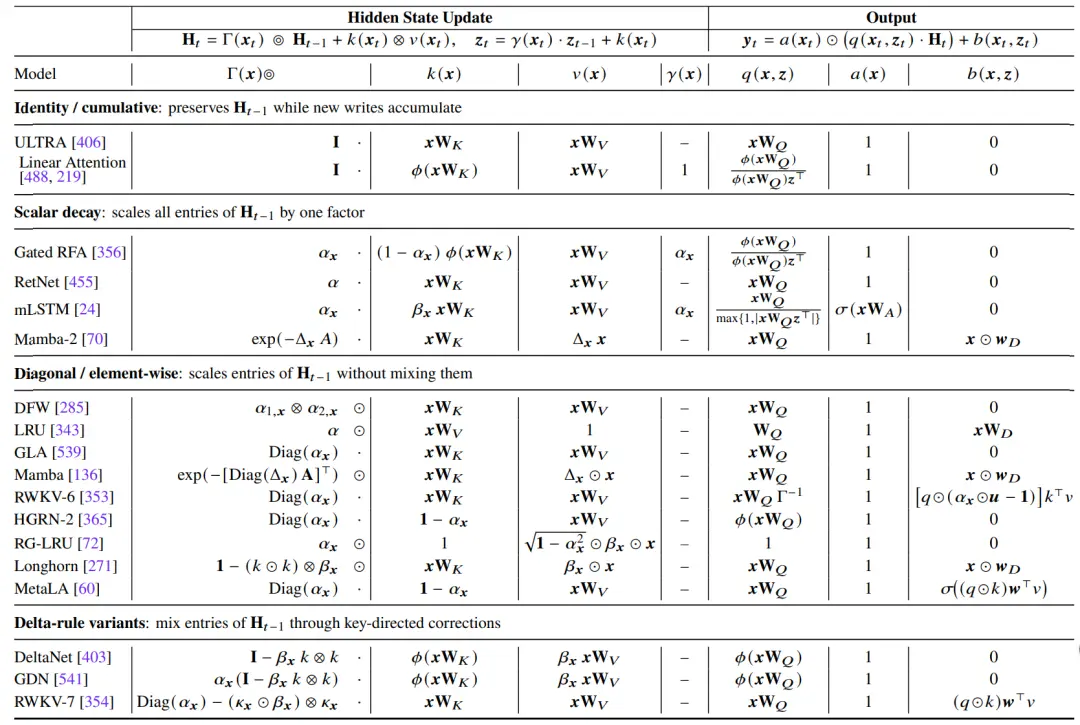
代表性线性注意力模型的统一形式对比(综述表 4)
线性语言模型一章介绍了当前源于 RNN、Fast Weight Programmers、状态空间模型的不同线性语言模型。虽然有不同的技术起源,这些线性模型本质可以写为同一种形式。文章因此通过两种不同的统一形式,将现今主流的线性模型的核心线性算子进行总结对比。
MoE 一章沿三条交织的脉络梳理其演进:先介绍稀疏门控 FFN 及其大规模训练所需的负载均衡与稳定性技术,再介绍细粒度专家加共享专家的布局,最后介绍在通信和显存约束下重新设计专家的系统级变体。
激活函数一章从 ReLU 讲到如今主流的 GLU 家族(如 SwiGLU)。归一化一章梳理了从 Post-LN 到 Pre-LN、RMSNorm 的演变,并讨论梯度消失与表示坍缩之间的 “跷跷板效应”。位置编码一章覆盖绝对位置编码、RoPE 和 ALiBi 等相对位置编码,以及 YaRN 等上下文扩展方法,也讨论了不用显式位置编码(NoPE)的模型。分词一章比较了字符级、词级和子词级分词器的取舍,并分析词表大小。
最后两章转向生成时的计算分配。多 token 预测一章按未来 token 的建模方式,把方法分为彼此条件独立的并行预测头(如 Medusa)和保留因果链的串行预测器(如 DeepSeek-V3 的 MTP 模块),并单独讨论投机解码中草稿的验证与接受。自适应与循环深度一章覆盖早退、按 token 选择执行哪些层的条件深度(如 Mixture-of-Depths),以及反复调用同一组层的循环 Transformer(如 Huginn、Ouro)。
开源模型的组合
第 14 章全面整理了从 LLaMA、Qwen 到 DeepSeek、Kimi、GLM、MiniMax 等所有主流开源模型的配置表,并归纳四种常见架构设计组合:标准稠密模型、拥有压缩注意力机制的稀疏专家模型(例如 DeepSeek-V2/V3)、注意力层与线性层交错的混合架构(如 Jamba、Qwen3-Next、Kimi Linear),以及拥有多 token 预测能力的模型。
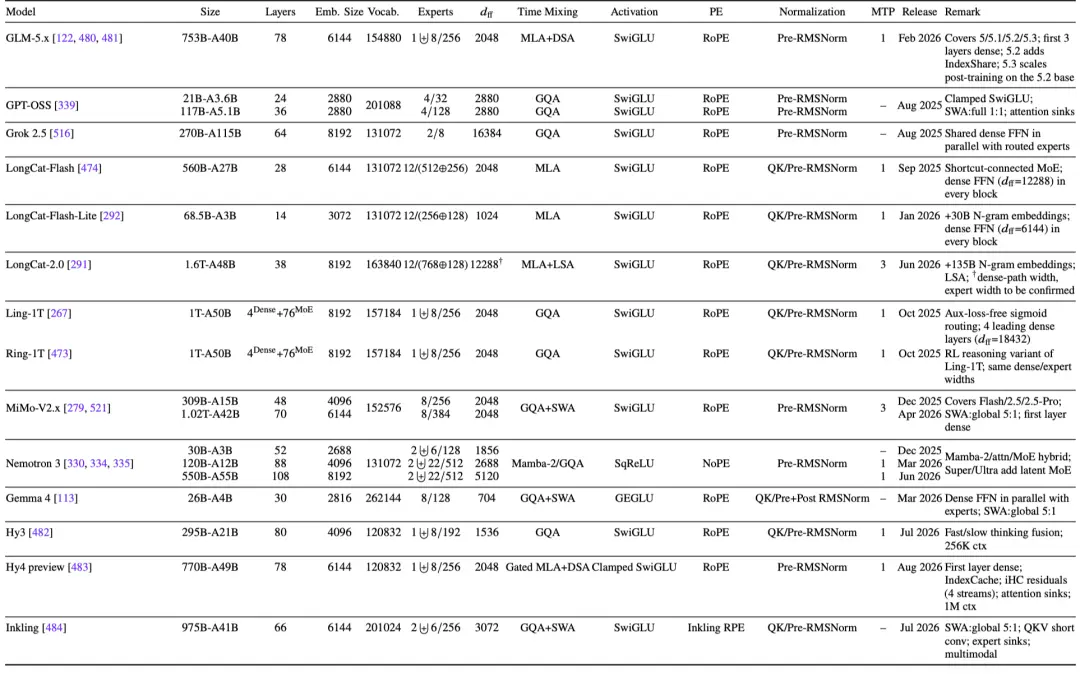
代表性 MoE 大模型的架构配置对比(节选自综述表 14)
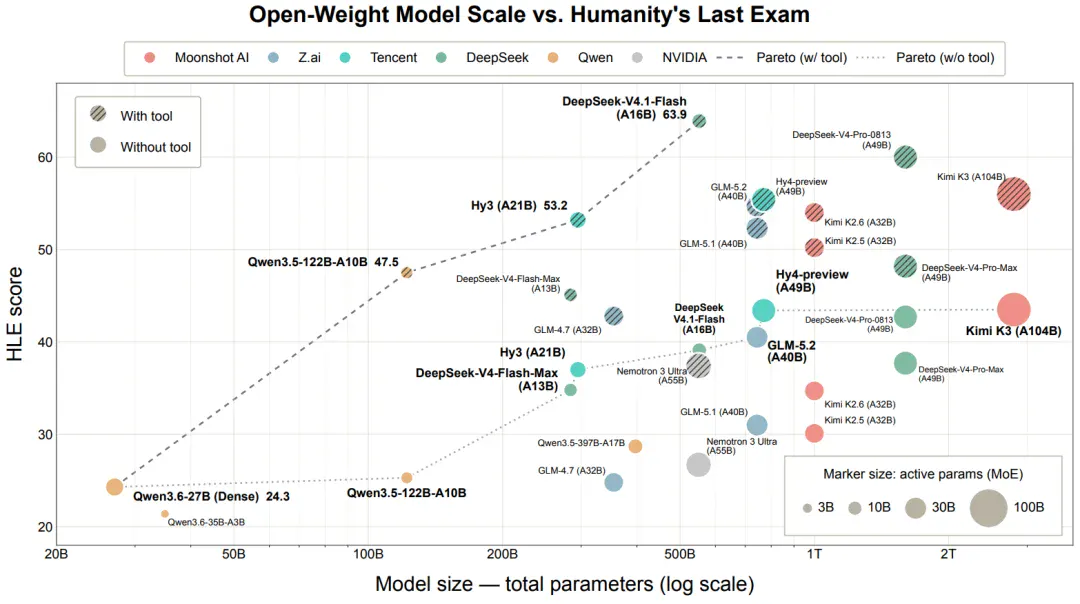
开源模型规模与 Humanity’s Last Exam 得分,模型标记面积随参数(MoE 模型看激活参数)的增大而增大
结论
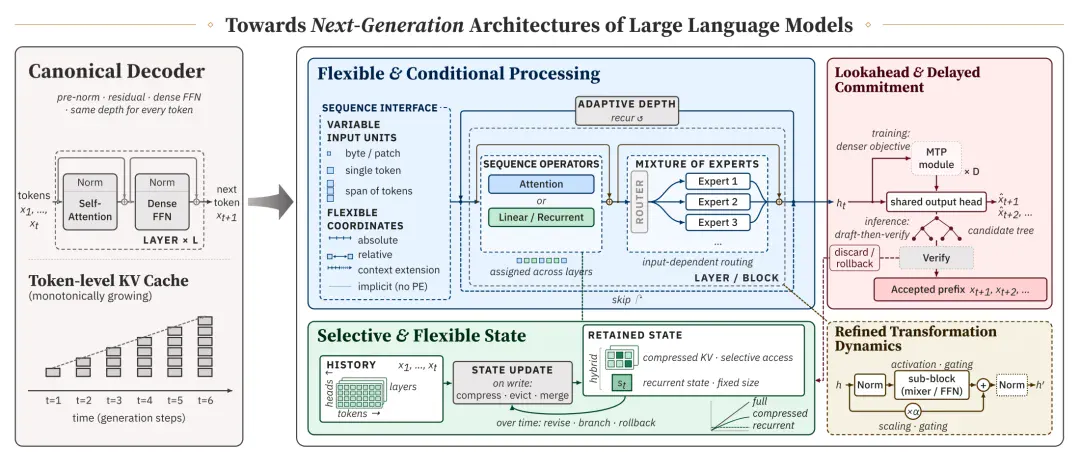
从标准解码器(左)出发,综述把近年的架构变化归为四个方向
综述给出三点观察。一,标准 decoder-only Transformer 仍是几乎所有新设计的参照,新工作大多保留这一框架,只改动其中的部分模块或运行方式,可归为四个方向:(1)灵活与条件化处理:避免每个 token 都被同样处理,如 MoE、早退和循环深度算法;(2)精细化的变换动态:保持计算路径不变,改进激活函数、归一化和残差;(3)选择性与灵活的状态管理:用带有压缩、筛选、循环功能的注意力模块,改进或取代原本的 KV 缓存机制;(4)lookahead 机制与延迟提交:将预测与提交解耦,如多 token 预测和投机解码。二,这些改动并不独立,一个模型常改几处,改一处会牵动别处的成本和收益,因此须整体评估。三,负载均衡、算子实现、缓存支持等 infra 实现,和模型设计一样决定能否让新架构落地。
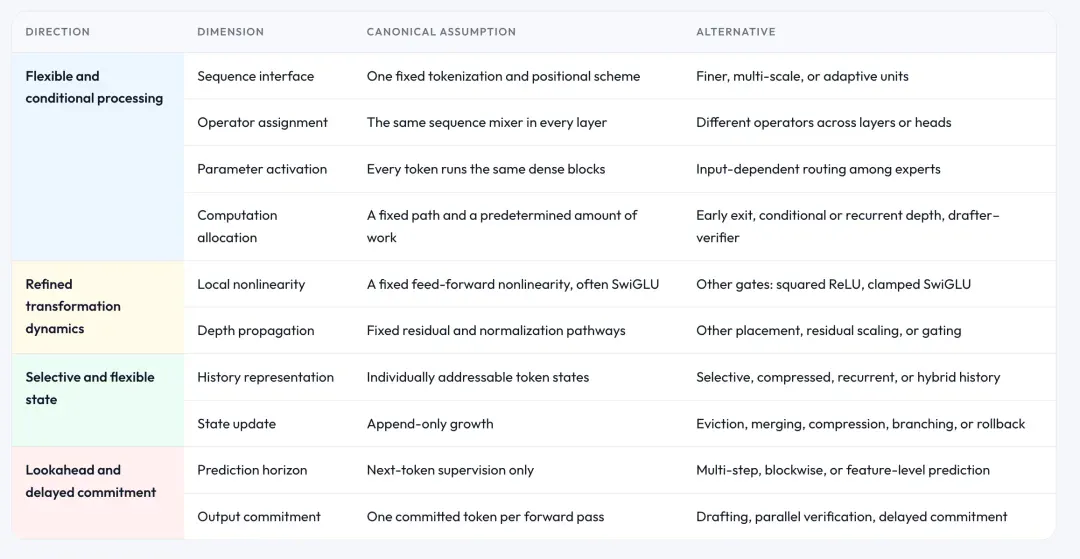
标准 decoder-only Transformer 的默认做法,以及近年架构在四个方向、十个维度上的改动
文章认为,下一代架构的特征,与其说是用某个单一模块取代注意力或稠密前馈网络,不如说是在 token、层和时间上,越来越自适应地分配计算、容量、状态和预测。其中,预测视野、循环深度和状态大小还缺少与 MoE 同等的 scaling law 研究,是待解难题。
此外,条件计算和循环计算在规模扩大后如何保持训练稳定,评测如何同时反映表达力、效率与稳定性之间的权衡,也都有待解决。解决这些问题,需要架构设计、优化方法与系统工程的持续配合。作者希望,这份综述能为此提供一张结构化的设计空间地图。
相关文章
 津公网安备12011002023007号