
「实测9大模型」
关于”AI 能不能搞科研”,行业里已经有两套完全不同的叙事。
一套来自 demo:模型证出了某个引理、改进了一个界,演示效果很漂亮。
另一套来自怀疑:那些题可能早就在训练数据里,或者只是把已有结论重新组织了一遍。
这两套叙事都缺一个东西:一个统一的、能自动判定对错的、覆盖完整科研产出形态的评测。
月之暗面(Moonshot AI)创始人&CEO杨植麟,联合清华大学、图灵奖得主姚期智团队共同推出 TCSExam,想补齐这块空白。
它的设计思路很直接:不看模型”说了什么”,只看它交出了什么。
四条赛道对应四类科研交付物:Lean 4 内核可通过的完整定理证明、可复用的求解器程序、带校验证书的显式数学构造、针对开放猜想给出证明或反证。全套共100道经领域专家审核过研究价值的任务。
评测结果反差十分明显:Full 榜单上 GPT‑6 Astra 以71.9分居首,定理证明赛道单次尝试成功率达到70.0%;第二名 Kimi K3.1 Pro 仅38.3%,其余参评模型最高仅11.7%。而30道开放猜想任务,8个大模型代理合计只交出2份被系统接纳的解答,且均是联网检索公开反例后改编得到。
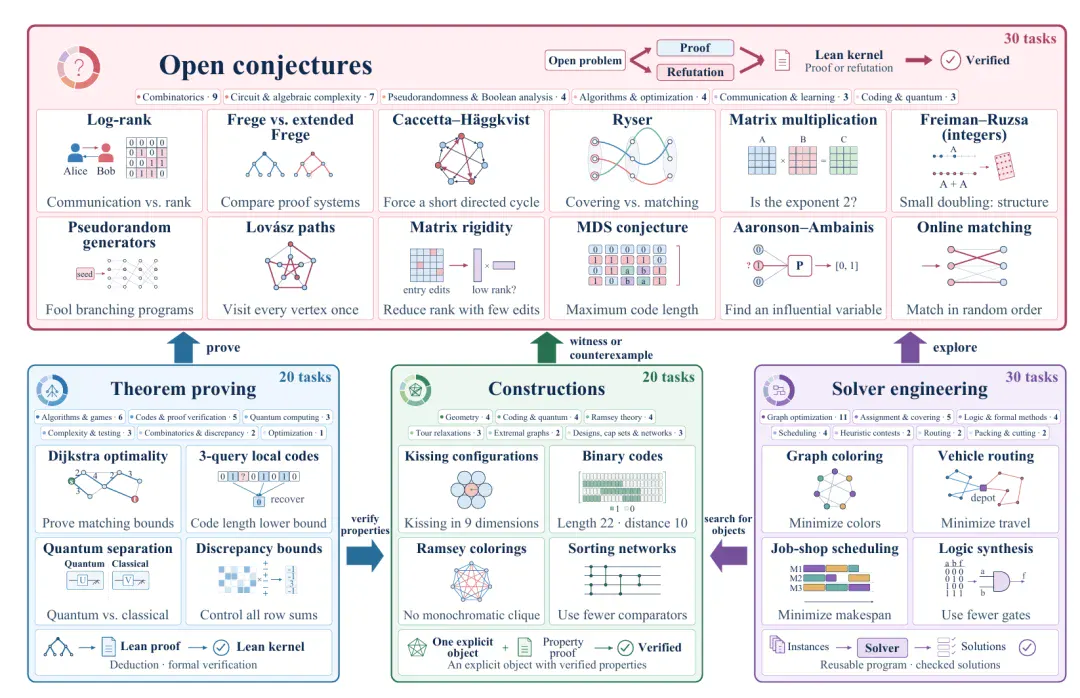
图 | TCSExam 通过四条评测赛道覆盖 TCS 研究的完整范围。箭头表示证明、搜索与构造如何相互支撑、并汇入开放猜想的求解 ©【深蓝AI】编译
1-它测的是”研究产出”,不是”数学答题”
1.1 四条赛道,对应四种真实科研动作
理论计算机科学的研究产出可以归纳为三类实体产出,再加面向未知问题的猜想攻坚:
- 定理证明(20 题):输入论文中形式化后的命题陈述,输出一份可在 Lean 4 中完整运行的证明。重点考察不是灵光一闪的思路,而是能否补全无逻辑漏洞的完整推导链条。
- 求解器工程(30 题):给定问题规格、朴素基线、公开样例,产出一套可复用程序,最终在一批隐藏测试实例上评估程序表现。
- 构造(20 题):输出显式数学对象与配套验证证书,例如特定参数的图、纠错码,由 Lean 或者可执行检查器核验参数指标。
- 开放猜想(30 题):输入形式化开放猜想,模型需要完整证明命题或者给出带证明的反例。
四类任务并不是相互独立的考试科目,现实科研中存在互相支撑的关系:求解器搜索候选对象,证明验证对象性质,构造产出见证样例或者反例,三者都可以服务于猜想推进。这也是它和普通数学竞赛类基准最核心的区别。
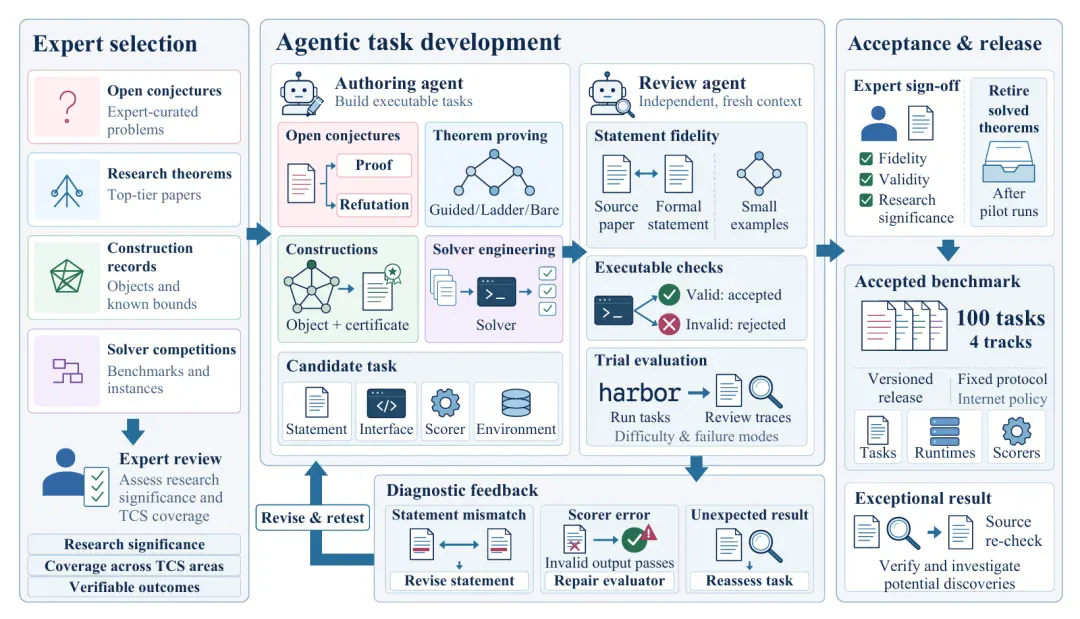
图 | 任务筛选与验证流程。专家选题之后,由代理辅助出题与独立审查、可执行检查与试跑评测;陈述不匹配、评分器错误与意外结果都会触发修订与重测 ©【深蓝AI】编译
1.2 为什么判定必须”硬落地”
过往部分TCS基准存在短板(表 1):TCS‑BENCH依靠大模型做裁判,即便宣称专家匹配度很高,但输出结果没有形式化层面的正确性保障,裁判模型本身会引入偏差;FormalTCS专注端到端形式化证明,缺少求解器、构造任务;FrontierCS覆盖求解与构造,但缺少定理证明、开放猜想赛道。
TCSExam 的所有判分全部交给机器内核:证明交由 Lean 内核校验,程序、构造对象交由可执行检查器运行核验,不存在”主观看起来合理”这一档结果。
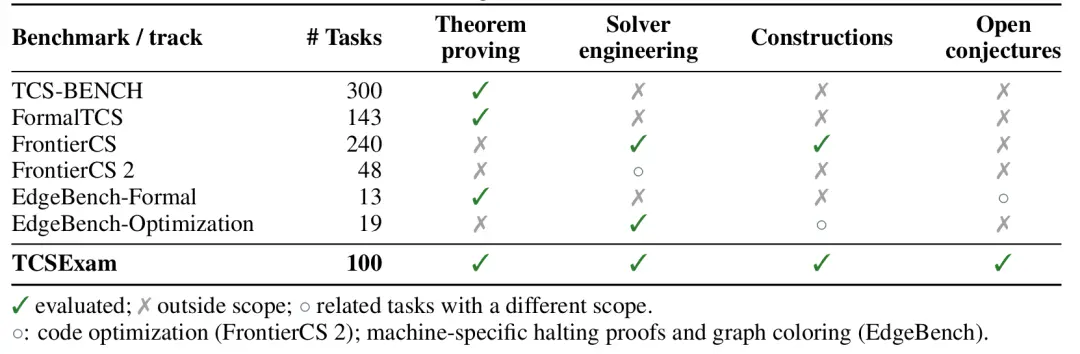
表 | 部分相关基准的覆盖范围对比 ©【深蓝AI】编译
2—题目是怎么造出来的
2.1 三档上下文,定位模型能力短板
定理证明赛道设置同一命题的三种输入上下文:
- bare:仅提供主命题陈述、固定定义与数学假设,评测的是从零完成证明的真实能力,也是主评测使用模式;
- ladder:额外给出中间引理的陈述;
- guided:进一步补充证明思路提示。
后两类主要用于消融分析,区分模型到底是想不到关键引理,还是有思路却补不全形式化的机械推导细节。
2.2 内置防污染出题流水线
任务不是人工写完就直接上线,完整流程:专家筛选具备研究价值的命题 → 代理生成命题描述、接口、评分器与运行环境 →另一组独立代理做交叉审查,核对命题和原始文献一致性,验证程序行为 → 试跑评测,发现问题退回迭代。
有两个关键防泄露设计:试跑阶段超过40道定理任务因为被模型直接解出而被淘汰,规避训练集见过的现成题目;求解器任务开发阶段对代理隐藏部分实例,公开实例做保结构变换,防止模型直接记忆答案。
3—分数怎么算:三个反直觉的设计
3.1 TCSExam‑Index 综合加权指标
四条赛道原始得分记为P(定理证明)、S(求解器)、C(构造)、O(开放猜想),综合Index = 30P + 30S + 30C + 10O。其中求解器得分做归一化映射到0‑1区间。
权重是人工约定的,论文本身也做了说明。设计逻辑偏向现实工程:现阶段稳定产出可核验的科研成果,比攻克开放猜想更能区分模型水平,猜想任务权重因此设置较低。Index可以理解为科研生产力综合得分,不等同纯粹数学智商得分。
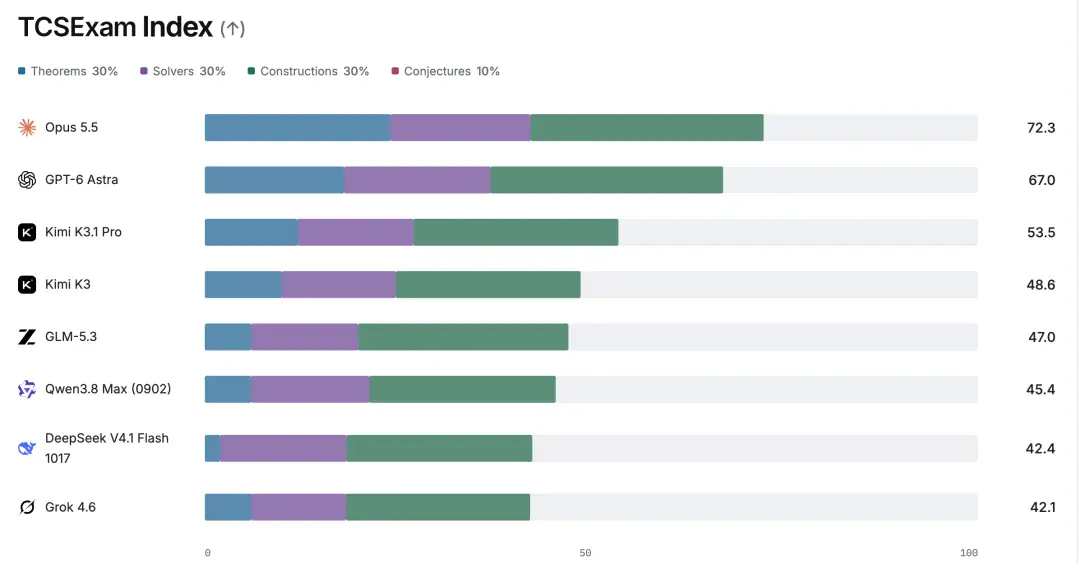
图 | TCSExam Index©【深蓝AI】编译
3.2 求解器指标:规避单条坏样本全盘拉低分数
早期版本使用基线与最优参考的差距比值,但该指标无上限,论文举例Qwen3.8 Max的一次输出,单个离谱程序就会把整条赛道均值彻底拉崩。
因此论文改用Kimi K3相对指标,以多次运行Kimi K3的输出作为基准,在均值附近保留敏感度,同时约束输出上下界,做高斯CDF变换。同一个模型,旧指标64.7%,修正后49.2%,目的就是防止个别极端输出主导整体评分。
3.3 构造任务允许得分超过100分
构造任务以平凡构造、文献记录最优值作为参考标尺,达到文献记录水平得100%,如果输出对象指标优于已有文献记录,得分可以高于100%;部分任务采用三次方塑形,其余线性计分。
Astra拿到104.9%,是参评模型中唯一均值破百,20道任务中17道持平记录,3道实现超越;GLM‑5.3均值97.7%,没有实现任何超越。指标可以区分两种表现:仅仅贴着历史记录完成,和真正实现指标突破。
4—结果:能力剖面呈现明显偏科
4.1 定理证明:出现巨大性能断崖
Astra在20道任务完成14道,裸上下文下成功率70.0%;Kimi K3.1 Pro60次尝试,覆盖9道不同命题,成功率38.3%,也解出Astra未能解决的PCP字母可靠性命题;Kimi K3成功率仅11.7%。GLM‑5.3、Qwen3.8 Max、Grok4.6仅5%。8个模型合计,仍存在4道任务没有任何模型完成证明。
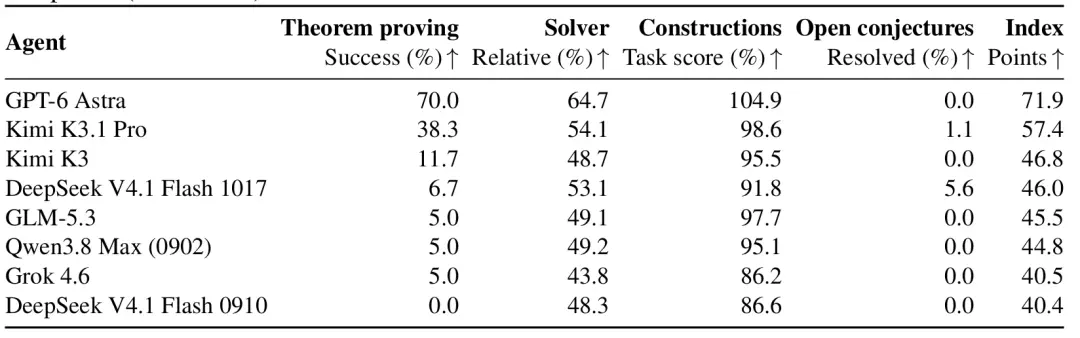
表 | TCSExam‑Full 在 100 道任务上的结果。赛道内任务等权;求解器用 Kimi K3 相对指标;构造得分 100.0% 表示与任务参考持平;Index 定义见 3.3 节 ©【深蓝AI】编译
客观提醒:70%的成功率只能作为参考。虽然流程淘汰大量可直接解出的题目,但只能规避整题记忆,无法完全规避模型见过同类引理;该结果还需要更多独立复现来进一步确认。
4.2 求解器:各家得分挤在狭窄区间
8个参评模型求解器相对得分落在43.8%‑64.7%区间,差距远小于定理证明赛道。Astra在27道任务拿到并列最优均值,仅少数集合优化任务被其他模型反超。
值得关注实例级表现:IWLS2023逻辑综合任务,Astra输出的程序全部输出有效电路,22个实例优于参考、31个持平、47个实例门数更多。比起平均分,这种分布更能体现能力:不是全方位碾压,而是部分样例真正找到更优解。
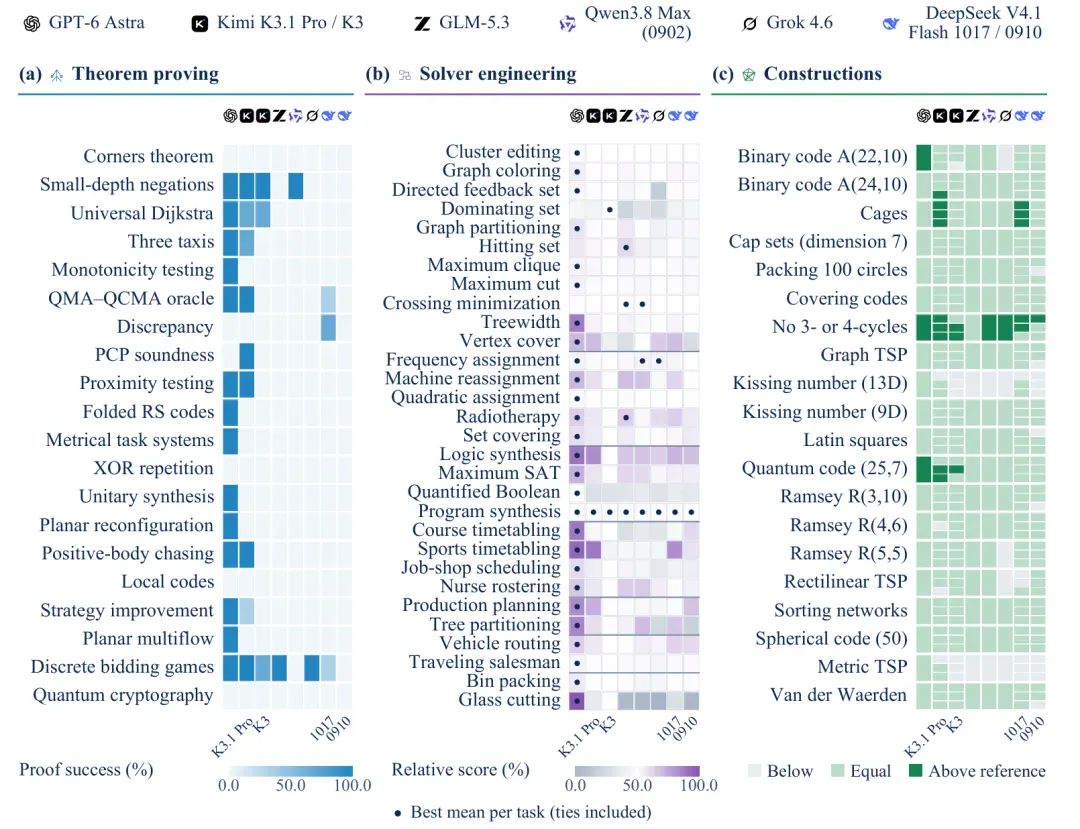
图 | 八个代理在 Full 上的任务级结果。(a) 完整证明成功率。(b) 以 Kimi K3 为基准的相对求解器得分,圆点为该任务的最佳均值。(c) 单元格纵向堆叠一到三次构造尝试,按低于/等于/高于任务参考着色 ©【深蓝AI】编译
4.3 构造任务:贴近历史记录,偶尔实现突破
构造赛道产出几份具备实际参考价值的结果: Kimi K3构造出124顶点、630条边的无3‑环、4‑环图,超越任务参考629边;同时构造[[25,7,6]]量子稳定子码,将25比特7逻辑比特的最小距离从5提升至6。 Astra收紧二进制码上界A(22,10) ≤ 82,把公开记录84向下压缩两格。
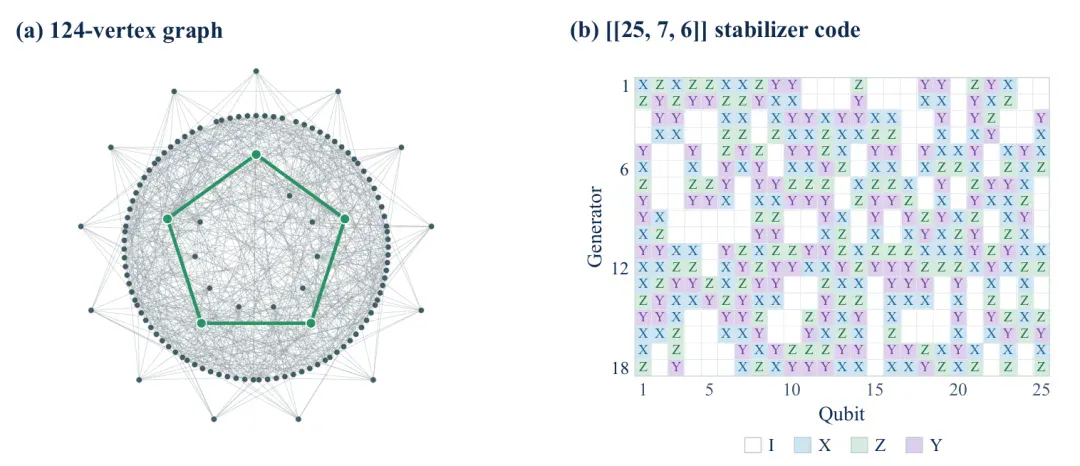
图 | Kimi K3 提交的两个构造。(a) 无 3‑/4‑ 环的图,124 顶点、630 边,超过 629 边的任务参考;绿色为最短环。(b) [[25,7,6]] 量子码的 18 个稳定子生成元,最小距离从 5 提到 6 ©【深蓝AI】编译
4.4 开放猜想赛道:有效解答来自检索改编
30道开放猜想,只有Kimi K3.1 Pro、DeepSeek1017拿到被接纳的结果,而且论文明确写明:模型在允许联网条件下检索到OpenAI公开的Ryser、MIRUP反例,再适配修改命题定义得到。其余28道猜想没有完整可核验解答。
也就是说,这一栏当前更多测的是检索‑改编能力,而非原生的猜想突破能力。但评测也捕捉到有价值的中间产出:Astra把Alon‑Jaeger‑Tarsi猜想在F5域的验证范围,从已知n≤8拓展到n≤9,得到Lean可核验的中间结论,虽然没有彻底解决猜想,但产出可复用的阶段性结果。
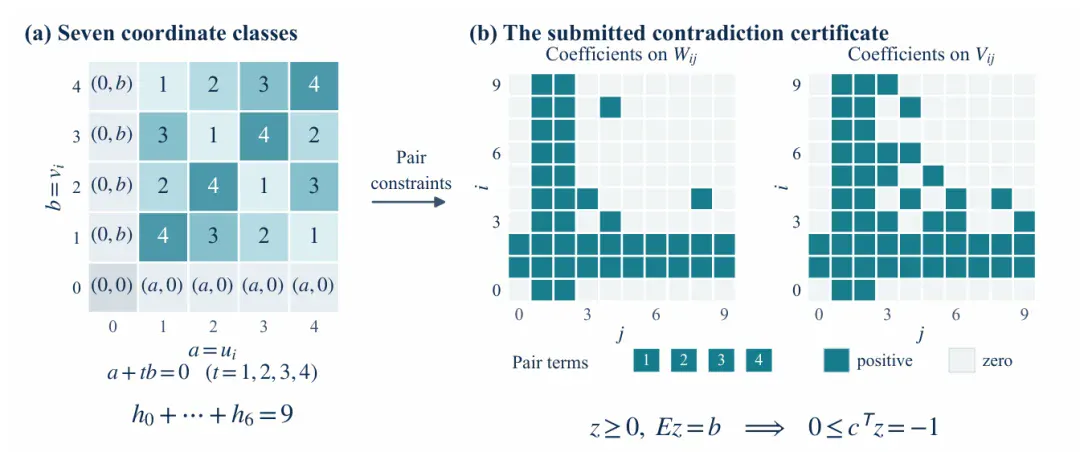
图 | Astra 为 F5 上九维 Alon–Jaeger–Tarsi 情形给出的证明证书。(a) 坐标对落入七个等价类,格内数字为满足 a+tb=0 的唯一非零 t。(b) 实际证书在两组成对计数与四个成对项上取非负系数,配合计数恒等式迫使非负和等于 −1,从而排除最小反例 ©【深蓝AI】编译
5—Lite子集:低成本快速摸底工具
Full全套100道任务,单轮评测开销巨大;Lite版本每条赛道抽取5道,合计20道任务,尝试量减少80%,单次尝试预算不变。8个共同参评模型,Full与Lite结果斯皮尔曼相关系数ρ=0.93,前三名保持一致,28组两两对比中26组排序不变。
差别来自开放猜想:那两道被成功解答的猜想任务不在Lite子集,Lite猜想赛道全部为0分。所以Lite适合快速做模型能力摸底,不适合评估开放猜想攻坚能力。
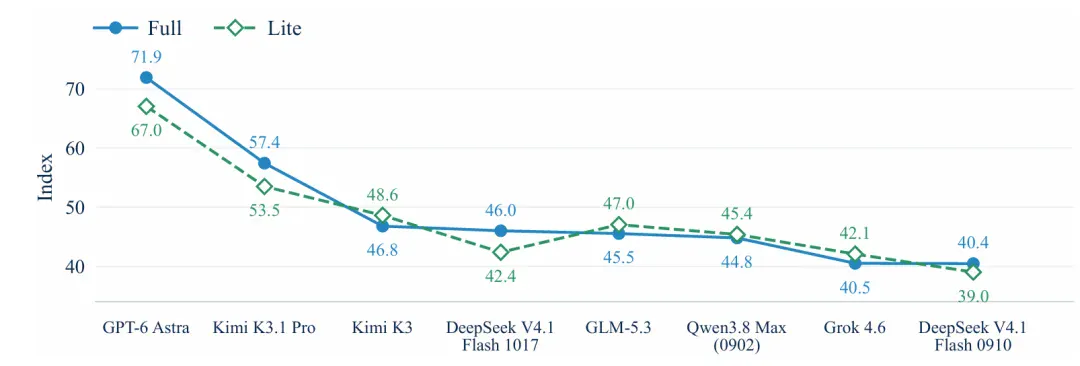
图 | Full 与 Lite 的排序高度一致。八个共同代理中两套测试给出相同前三名,28 组两两比较中 26 组一致(ρ=0.93)©【深蓝AI】编译
额外加入的Opus5.5仅跑Lite,拿到Index72.3,小幅超过Astra的67.0。这也体现小样本评测天然带有抽样噪声,不能直接等价Full榜单结论。
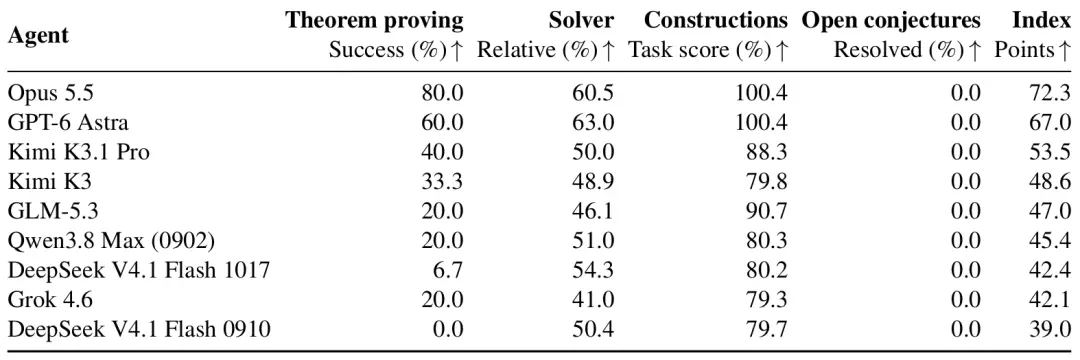
表 | TCSExam‑Lite 在 20 道任务上的结果,每条赛道五题 ©【深蓝AI】编译
6—写在最后
TCSExam最大价值不是榜单数字,而是把“大模型做理论计算机科研”这件事,从博眼球的演示demo,推进到机器可核验交付物的层面。
从四条赛道结果剖面可以看到:模型擅长搜索、验证这类闭环迭代任务,能够补齐形式化推导,在已有命题基础上产出改进构造;但是面向完全未知开放猜想的原创突破,目前依旧非常薄弱,现有有效案例依赖检索已有公开反例。
当然基准本身也会迭代:后续任务库会不断扩充,随着模型能力上涨旧题目会被逐步“吃满”;同时开放猜想断网评测、进一步防污染设计,都是后续需要完善的方向。但这套框架,已经为大模型理论科研能力,提供了一套可复现的评测底座。
相关文章
 津公网安备12011002023007号